AIが「15%」と言った。では、私は何を知ったのか――Meaning Auditから認識論を訪ねる
天気予報の降水確率15%は受け入れやすい。でも「彼女が彼を好きである確率は15%」と言われると、その15%が気になる。AIの答えを見て、私は何を知ったことになるのか。シリーズ「意味の地図をつくる」第1回は認識論を訪ねる。

天気予報の降水確率15%は受け入れやすい。でも「彼女が彼を好きである確率は15%」と言われると、その15%が気になる。AIの答えを見て、私は何を知ったことになるのか。シリーズ「意味の地図をつくる」第1回は認識論を訪ねる。
意味の監査を考えていたら、周りに学問があった。認識論、語用論、解釈学、記号論、Knowledge Graph。シリーズ「意味の地図をつくる」の入口として、これから訪ねる十九の領域を一覧する探索地図。
2023年、私はChatGPTに本を書いてもらった。2026年、もう一度AIと本を書いた。AIの利用量は増えたのに、原稿への関与はむしろ深くなった。変わったのは関与の量ではなく、何にコミットしていたかだった。
生成AIで網羅的な文章を作るコストがほとんどなくなった。情報をたくさん書けること自体は、もう希少ではない。未理解からの省略と、理解からの省略は外形が似ているが、中身はほとんど反対である。
自分の記録をAIに読み込ませて「自分AI」を作ると、記録の中にある他人の発言まで本人の思想として語り始める。これは検索精度とは少し違う問題で、Speaker Attribution・Stance・Commitment・Condition・Temporal Versioningを分けて持つ必要がある。
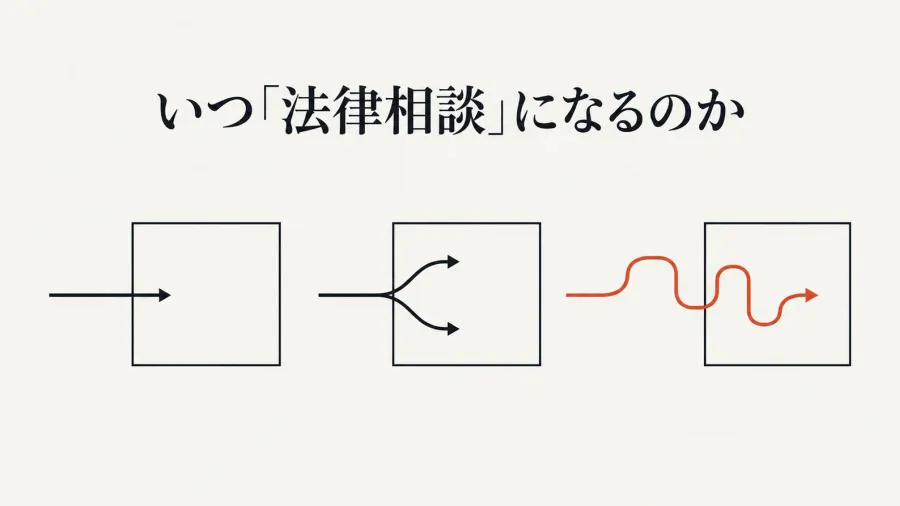
2026年8月の法務省ガイドラインを読んでいて気になったのは、個々のAIサービスが合法か違法かという判定よりも、その判定に至るまでに何が見られているのかだった。同じLLMでも、設計・UI・利用のされ方で意味は変わる。
18章すべての原稿がそろった。ところが一本につないで読める形にしたところ、別の仕事が始まった。章ごとには正しいのに、章と章のあいだが古い。本にも依存関係があり、編集は概念モデルのデバッグでもあった。
「好きな食べ物は?」と聞かれると、反射的に「やきそば」と答えてきた。嘘ではないが、純粋な嗜好調査の結果でもない。趣味、ホーム、好きな食べ物。自己紹介で差し出す短い答えは、本体ではなく取っ手なのかもしれない。
LISS Panelへのアクセスを断られ、代わりのデータを探し始めた。ところが調べてみると、AIペルソナやLLMによる社会調査データ生成について、すでにかなり近い研究と、検証に使える実データがいくつも存在していた。
AIに議事録を作らせると、「気が楽」は「心理的負担が軽減された」になる。文章としてはよくできている。でも、その少しの間にいくつかの意味が追加されている。その一文は、誰が言ったことなのか。
「週20時間必要」と「2人必要」は同じ種類の意味ではない。報告資料に意味の監査を試したら、条件と提案の間に余計な矢印が入っていた。意味が混じると異論の場所が分からなくなり、議論は止まる。
「なぜ〇〇は△△なのか」というタイトルは、秘密を隠しているわけではない。隠されているのは、その二つを結ぶものだけだ。情報をいつ出すかと、意味をいつ確定するかは同じではない、という話。